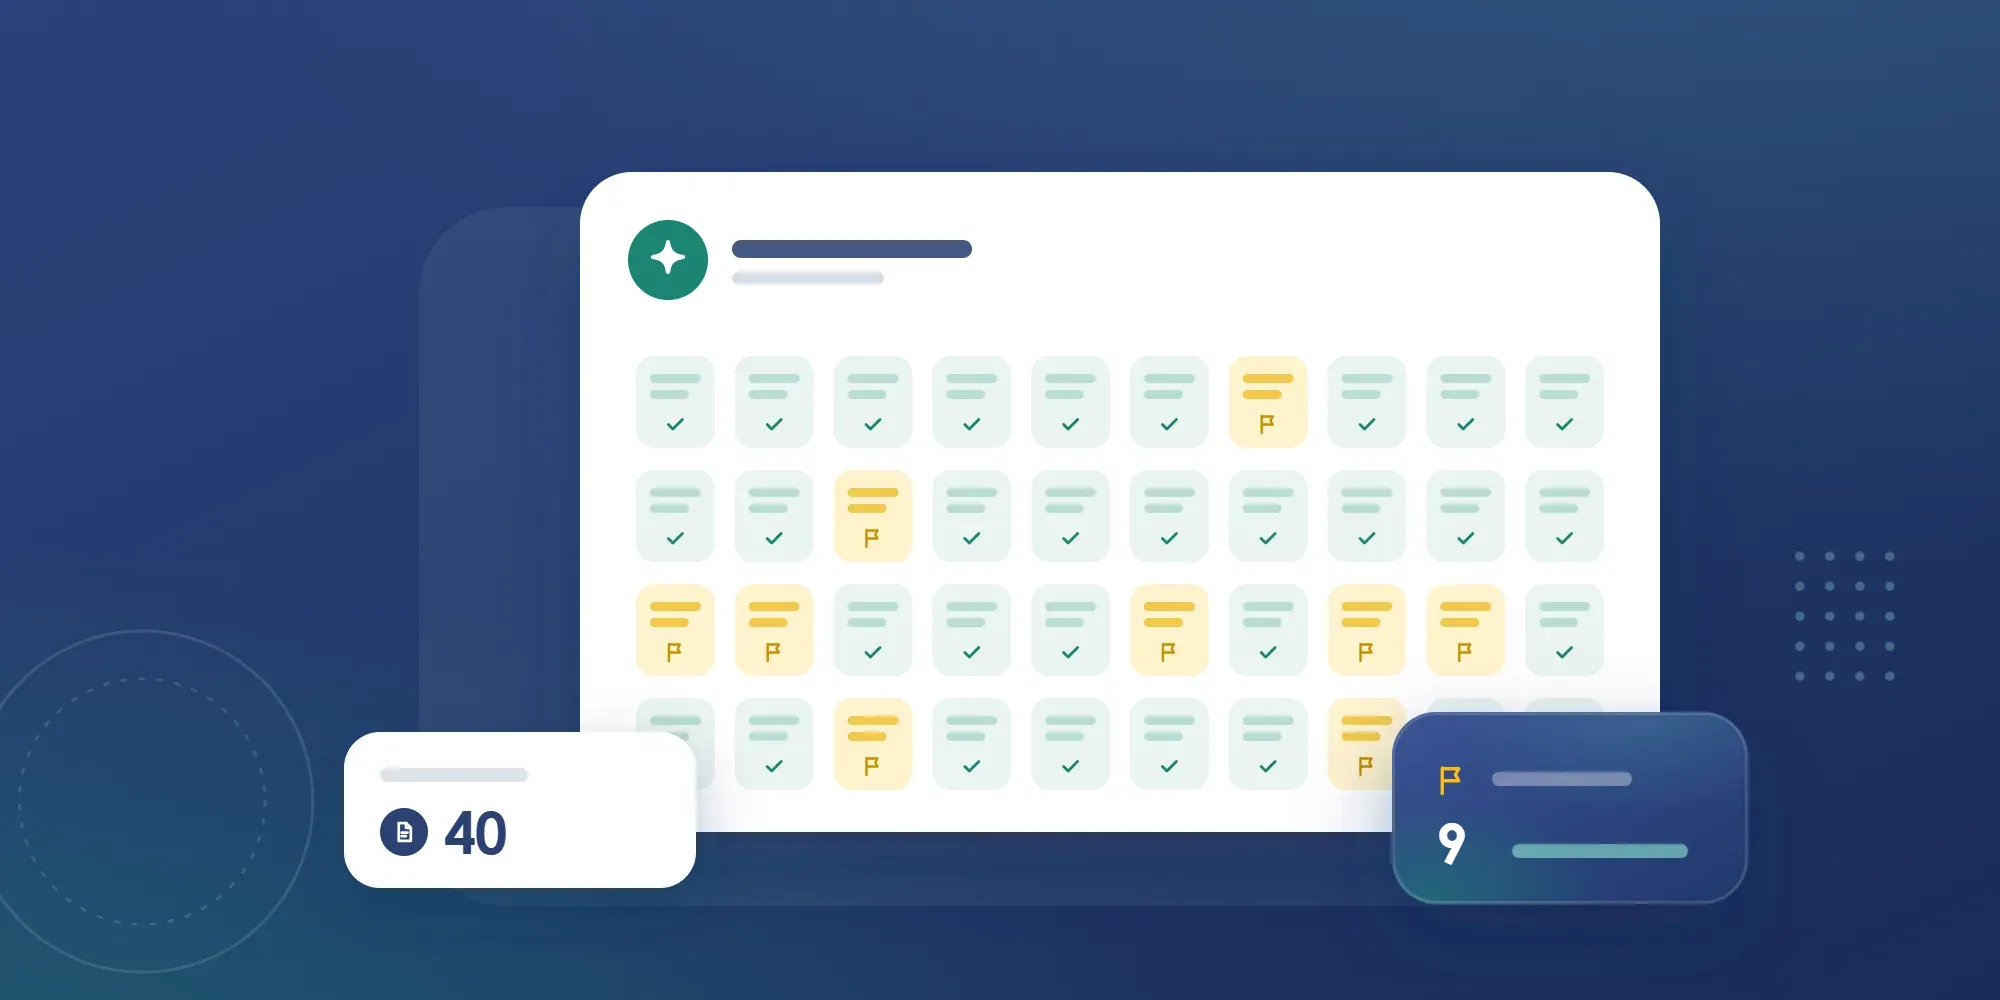
كل وكالة في العالم قضت هذا العام تسمع السؤال نفسه من عملائها: ألا يمكننا استخدام الذكاء الاصطناعي للمدونة؟ فأجرينا التجربة بشكل سليم. 40 بريفًا حقيقيًا من عملائنا، وثلاث من أشهر أدوات الكتابة، ونفس البريفات أُعطيت لكاتب بشري، ومراجعة عمياء من محررين اثنين لم يعرفا أي مسودة تخص أي جهة.
ما أجادته الأدوات
البنية كانت ممتازة. بإعطائها كلمة مفتاحية ومخططًا، عادت المسودات منظمة وفي صلب الموضوع وسليمة لغويًا، في نحو 4 دقائق مقابل نحو 3 ساعات لمسودة بشرية أولى. وفي البريفات التي يكون محتواها سلعة نمطية، كصفحة تعريف أو شرح إجراء مباشر أو مدخل في مسرد، كانت الفجوة في الجودة صغيرة والفجوة في التكلفة هائلة.
وكانت جيدة أيضًا في العمل المحيط الممل: أوصاف الميتا، والعناوين البديلة، والملخصات، وتحويل مقال واحد إلى سلسلة منشورات.
أين تعثرت أدوات الكتابة بالذكاء الاصطناعي
ثلاثة إخفاقات تكررت في كل بريف تقريبًا. أولًا، التفاصيل المخترعة. إحصاءات بلا مصدر، واقتباسات لأشخاص لم يقولوها، وأرقام دراسات حالة تبدو تمامًا كالأرقام الحقيقية. أمسك محررونا 11 رقمًا مفبركًا عبر 40 قطعة، وهذا على نطاق واسع حادث سمعة ينتظر وقوعه.
ثانيًا، غياب وجهة النظر. لخصت المسودات إجماع كل ما نُشر سابقًا، ما يعني بالتعريف أنها لم تقل شيئًا جديدًا. وحين قيّمنا القطع على معيار هل سيتعلم القارئ شيئًا ليس موجودًا أصلًا في الصفحة الأولى من النتائج، فازت المسودات البشرية 38 مرة من 40.
ثالثًا، وهو الأغلى ثمنًا لعملائنا، غياب التفاصيل من واقع التجربة. صفحة عن إدارة حملات ممولة في مصر يكتبها نموذج لم يرَ فاتورة عميل قط، ولم يجادل موظف دعم في منصة، ولا يعرف أن الدفع عند الاستلام يغير القمع كله. وهذه التفاصيل بالذات هي ما يجعل المحتوى يتصدر ويحقق تحويلات.
كيف نستخدمها الآن
كمساعد بحث ومحرك مسودة أولى للصفحات النمطية، لا كناشر أبدًا. كل قطعة تذهب إلى إنسان يضيف الأرقام والرأي والواقع المحلي، ثم إلى محرر يتحقق من كل ادعاء. الوقت الموفر حقيقي لكنه متواضع، نحو 30%، والجودة تصمد.
ظل Google متسقًا في هذه النقطة: يكافئ المحتوى المفيد بغض النظر عن طريقة إنتاجه، ويخفض المحتوى المنتج أساسًا من أجل الترتيب. هذا المعيار لم يتغير، ولهذا ما زالت خدمات تحسين محركات البحث لدينا تبدأ باستراتيجي لا بأمر نصي.